共计 2502 个字符,预计需要花费 7 分钟才能阅读完成。
在嵌入式开发中,状态机几乎无处不在。比如两轮车VCU中,我们至少需要设防,解防,接近,开机,骑行,故障,离开,锁车,开锁等状态。
当然,设备启动需要状态机,蓝牙连接需要状态机,OTA升级需要状态机,电机控制需要状态机,甚至一个按键处理都可以看成一个状态机。
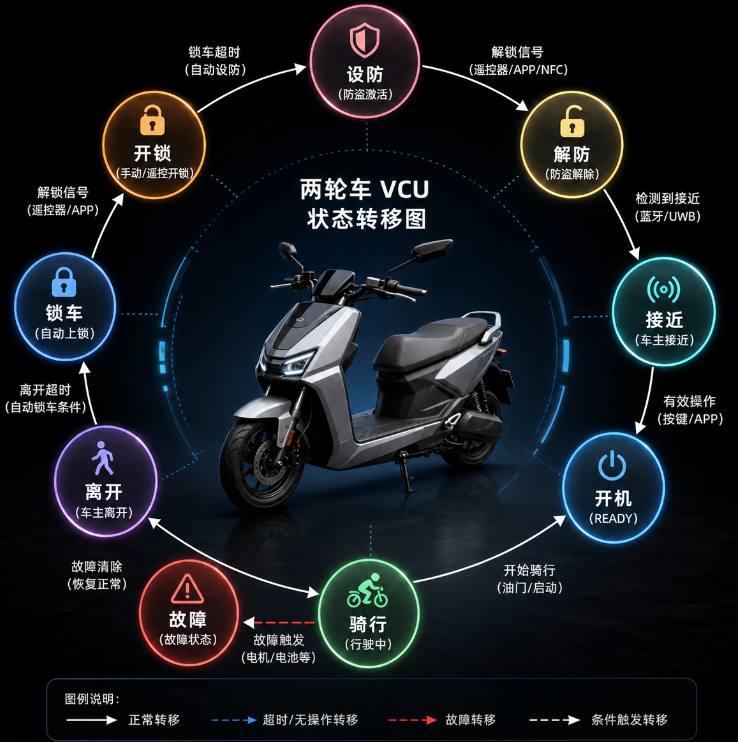
最开始写状态机的时候,绝大多数工程师都会选择最直接的方式:switch-case。因为它简单、直观。
比如一个设备自检流程:
设备上电以后处于空闲状态:IDLE
收到启动命令:START
进入检测状态:RUN
检测成功:SUCCESS
检测失败:FAIL
于是代码很自然地写成:
switch(state)
{
    case IDLE:

        if(event == START)
        {
            start_check();
            state = RUN;
        }

        break;


    case RUN:

        if(event == CHECK_OK)
        {
            state = SUCCESS;
        }
        else if(event == CHECK_ERR)
        {
            state = FAIL;
        }

        break;


    case SUCCESS:

        break;


    case FAIL:

        break;
}
这样的写法,刚开始没有任何问题。几个状态,几个事件,一眼就能看懂。
但是,嵌入式项目最容易出现的问题就是,产品需求会不断增加,SB领导不断的加戏,在没有AI的时代,这简直就是噩梦,即便现在有了AI的时代,你还得担惊受怕的夜不能眠。
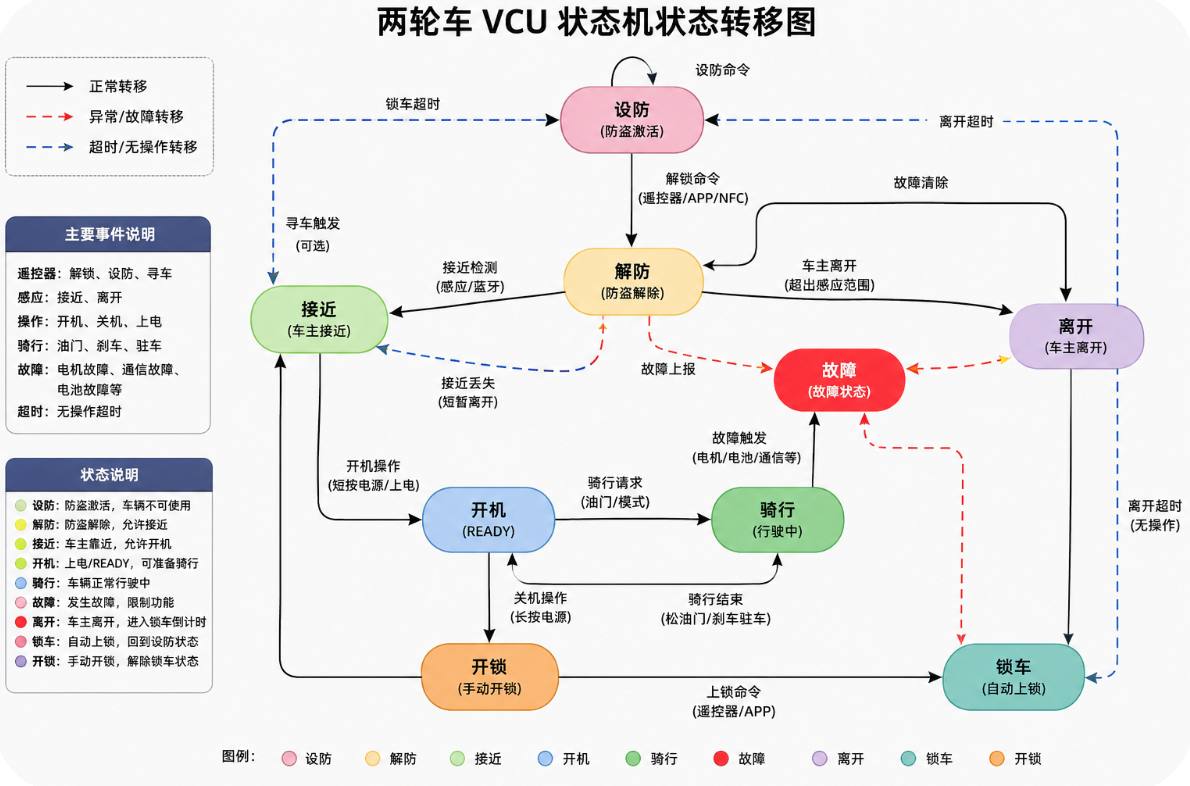
状态机真正复杂的地方,不是状态,而是组合
假设最开始只有:IDLE 、RUN 、SUCCESS 、FAIL四个状态。
后来需求增加:
- 检测超时
- 自动重试
- 电压异常
- 温度异常
- 通信失败
- 用户取消
- 低功耗唤醒
状态越来越多:IDLE, RUN, WAITPOWER, WAITSENSOR, RETRY, SUCCESS, FAIL, TIMEOUT, ERROR等
事件也越来越多:START、OK、ERROR、TIMEOUT、CANCEL、RETRY
这时候问题出现了。
switch里面开始不断增加判断:
switch(state)
{
    case RUN:

        if(event == OK)
        {
            ...
        }
        else if(event == ERROR)
        {
            ...
        }
        else if(event == TIMEOUT)
        {
            ...
        }
        else if(event == CANCEL)
        {
            ...
        }

        break;


    case RETRY:

        if(event == OK)
        {

        }
        else if(event == TIMEOUT)
        {

        }

        break;
}
代码并不是因为复杂逻辑变复杂,而是因为状态迁移关系越来越多。
实际上,一个状态机最核心的信息只有三个:当前状态,发生事件,下一状态。
例如:
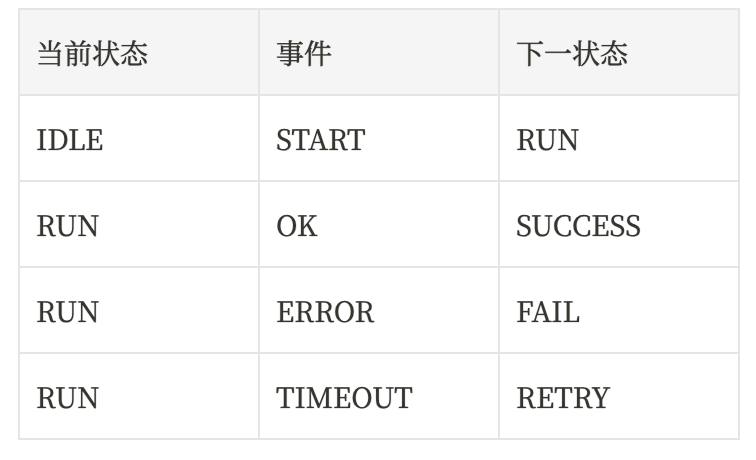
所以,这些东西本质上是一张数据表,既然状态迁移本身就是数据,为什么还要写成大量代码?
表驱动状态机:把流程从代码中拿出来
状态变化不再写在 switch 里面,而是定义一张表,结构如下:
typedef struct
{
    uint8_t from;       // 当前状态
    uint8_t event;      // 触发事件
    uint8_t to;         // 目标状态
    void (*action)(void); //执行一些操作
} state_trans_t;
然后描述所有状态变化:
static const state_trans_t table[] =
{
    {
        IDLE,
        EVENT_START,
        RUN,
        check_start
    },
    {
        RUN,
        EVENT_OK,
        SUCCESS,
        check_success
    },
    {
        RUN,
        EVENT_ERROR,
        FAIL,
        check_fail
    }
};
这张结构化的表其实就是状态转移图。
以前:代码决定状态怎么走
现在:数据表来决定状态怎么走,代码负责执行,代码几乎不用动了。
状态机运行过程
状态机只需要一个统一入口:
void fsm_process(fsm_t *fsm, uint8_t event)
{
    for(int i=0; i<table_size; i++)
    {
        if((table[i].from == fsm->state)&&(table[i].event == event))
        {
            fsm->state = table[i].to; //下一个状态
            if(table[i].action) //如果有需要执行的操作,执行。
            {
                table[i].action(fsm);
            }
            return;
        }
    }
}
例如
当前状态:IDLE。
收到:EVENT_START
程序遍历表,然后找到IDLE + START事件,对应状态:RUN。
于是:IDLE ——> START时间 ——> RUN
同时执行:check_start();
下一次
当前状态:RUN
收到:EVENT_OK
继续查表,找到:RUN + OK,于是:
RUN ——> OK ——> SUCCESS
整个流程完全由表控制。
为什么工程项目喜欢这种方式?
因为它解决的不是代码量问题,而是架构问题。比如两轮车的车身控制器:
整车状态:解防护,手机接近,解锁中,骑行中,锁车中,故障
事件:解防,开锁,关锁,电机过流,超时,锁车
如果使用switch-case,几年迭代下来,很容易变成几千行状态判断。
而表驱动:
增加一个状态,只增加一个枚举。
增加一个流程,只增加一行表。
例如增加:RUN → TIMEOUT → RETRY
表中只需要:
{
    RUN,
    EVENT_TIMEOUT,
    RETRY,
    retry_start
},
核心调度代码完全不用修改。
但是表驱动不是万能的
它适合:通信流程、OTA升级、设备生命周期、蓝牙连接、网络连接。
这些场景特点是:状态明确,事件明确。
但是如果逻辑变成:
如果温度超过80度

同时电池电压低于3V

并且通信已经断开3次

进入保护模式
这种复杂条件判断,用表驱动反而会变得困难。那么通常做法是让状态机负责“大流程”,然后让状态内部负责“小逻辑”。
也就是:
状态迁移 → 表驱动
状态动作 → C代码
最后
switch-case状态机的问题,不是它不好,相反,在简单项目中,它是最清晰的方案。
但是随着产品迭代,状态数量和事件数量增加,switch-case会逐渐变成一个巨大的逻辑网。而表驱动状态机的核心思想是不要把“状态如何变化”写死在代码里,而是把它描述成数据,让代码负责执行规则,表只负责描述规则。
这也是为什么很多成熟嵌入式系统、协议栈和汽车电子软件,最终都会从简单的switch-case状态机,逐渐演化到表驱动状态机。